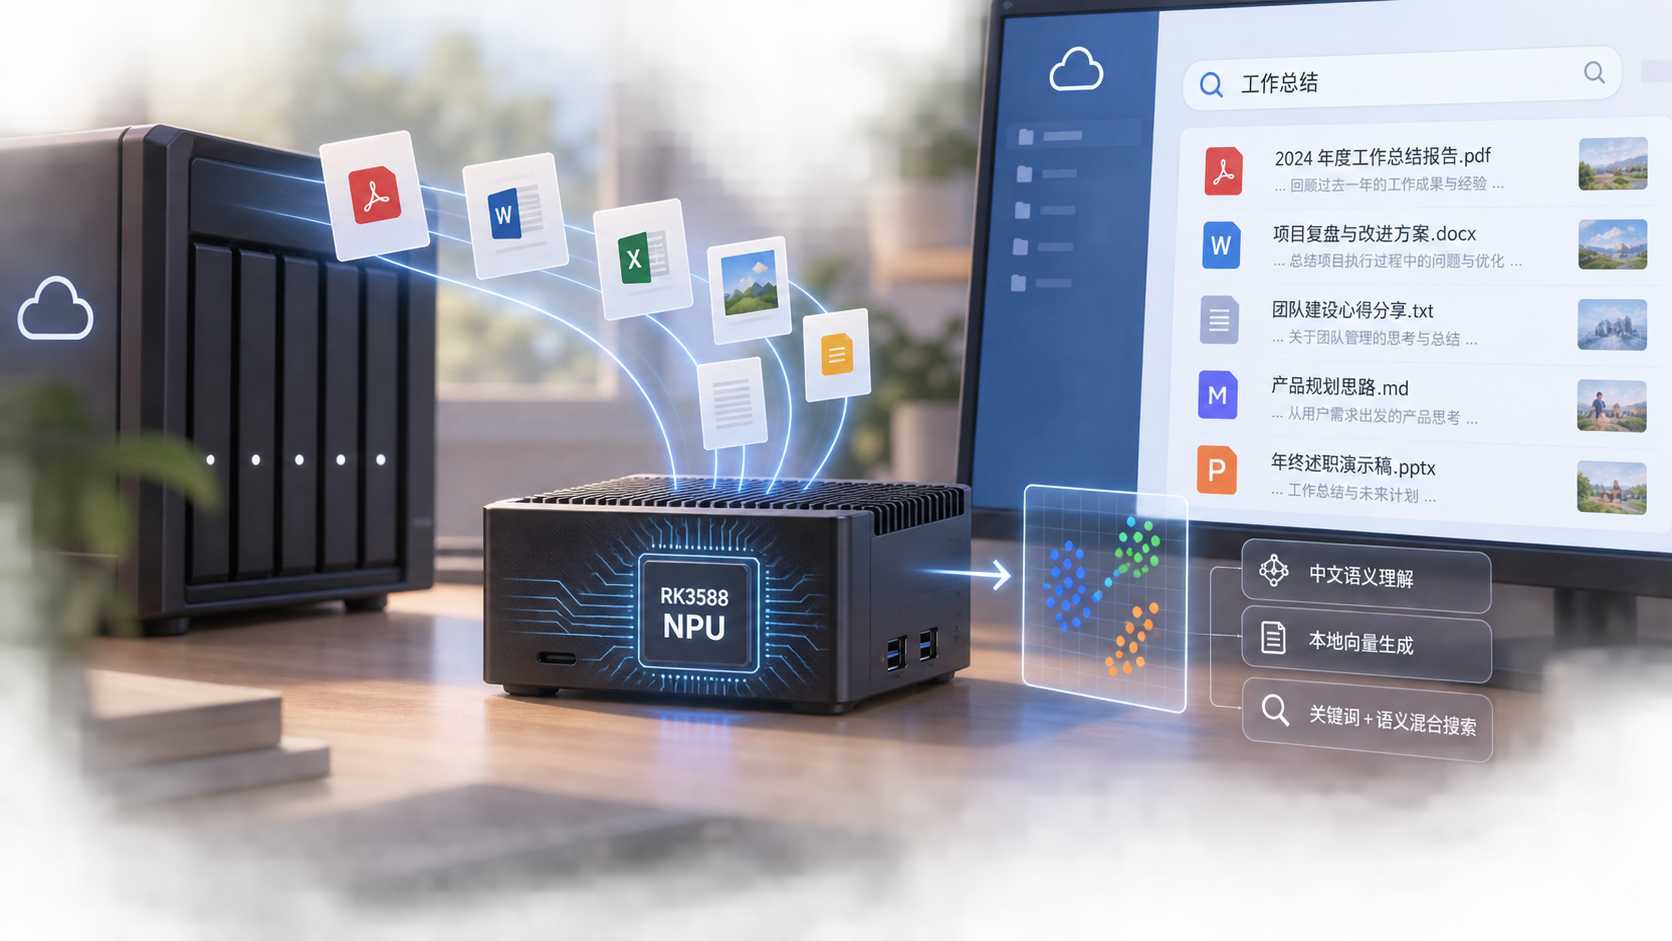
把网盘文件索引做成全文搜索之后,很快就会遇到一个瓶颈:关键词匹配能查到"包含这个词的文件",但查不到"意思相近的文件"。想解决这件事,通常有两条路——接一个云端嵌入 API,或者在自己机器上跑一个嵌入模型。前者要在费用和隐私之间做取舍,后者听起来很重,但如果手边恰好有一台带 NPU 的 ARM 盒子,它就变成一件值得试的事。
这篇记录的就是后者:在一台 RK3588 的 ztl A588 盒子上,用 NPU 跑 bge-small-zh-v1.5(512 维),给 Cloudreve 做本地语义搜索。全文不出现任何云端 API 调用——所有业务文本只在盒子内部的私有网桥和宿主机服务之间传输,没有模型服务费用,也不存在把文档正文发给第三方的问题。在线阶段只执行已经下载到本地的模型,不会从远程加载任何业务数据。
为什么要本地嵌入
先说清动机,因为这决定了后面所有架构选择。
不上云:索引的对象是自己的文档正文。嵌入 API 意味着把正文切片发出去,即便服务商承诺不留存,链路本身也变长了。
不烧 API 费用:语义搜索需要为每个分块生成向量,还要在文档更新时重新生成。用量一涨,按量计费就很显眼。
延迟可控:模型在本机,往返只有内网一跳,不受外部服务限流影响。
设备本来就有算力:RK3588 的 NPU 标称 6 TOPS,平时处于闲置状态,正好拿来跑一个轻量编码器。
需要说明的是,NPU 的"6 TOPS"不能直接换算成检索速度。真正决定体感的是编码器调用耗时,这必须实测。
硬件与环境前提
本次实测环境:
模型选择 BAAI/bge-small-zh-v1.5:512 维、4 层 BERT、最多 512 token,是面向中文检索的轻量嵌入模型。运行库用 RKNN Toolkit2 / Lite2 / Runtime 2.3.2。整套做法不需要升级驱动、内核或固件,这一点很重要——在 ARM 盒子上动内核往往是最大的风险来源。
架构:一个宿主机 systemd 服务,不是 Docker 容器
先给出最终落地的结构,再解释为什么不是别的样子。
Cloudreve → Tika 提取 → Meilisearch 文本分块
                             ↓ 私网桥 HTTP + Bearer 认证
                   宿主机 NPU 嵌入服务
                   CPU 分词/查表/归一化
                   NPU Transformer 编码器
                             ↓
                  Meilisearch 关键词 + 语义混合搜索
正式服务是宿主机上的 systemd 服务,服务名 cloudreve-embedding.service,状态 enabled/active。之所以强调这一点,是因为它直接对应下面这个坑。
为什么 Docker 实验没有通过
最初的尝试是把服务放进容器,结果卡在 RKNN SDK 的平台识别上:SDK 会读取设备树来识别平台,而 Docker 默认屏蔽了 /sys/firmware,即便把该路径只读映射进容器,也不满足 SDK 的识别条件。最终没有去改 SDK 的磁盘文件,也没有去动系统硬件信息,而是改成专用用户的宿主机服务。实验容器已停止并删除;实验源码保留在项目的 experiments 目录里,但它不能作为正式部署入口,生产期间也不得运行实验用的 Compose。
结论:在 RK3588 上跑 RKNN 这类依赖设备树的 SDK 时,先确认容器是否遮挡了平台识别所需的信息,不要把"改 SDK"当成解法。
服务的安全与资源边界
一个常驻的模型服务不应该拿宿主机当实验场,所以边界写得比较细:
上面这些边界最终就是下面这个 systemd 单元(源文件在 /root/AI/cloudreve-embedding/cloudreve-embedding.service,部署为 /etc/systemd/system/cloudreve-embedding.service):
[Unit]
Description=Cloudreve local RK3588 NPU embedding
After=network-online.target docker.service
Wants=network-online.target docker.service
StartLimitIntervalSec=0

[Service]
Type=simple
User=cloudreve-embedding
Group=cloudreve-embedding
SupplementaryGroups=render video
WorkingDirectory=/opt/cloudreve-embedding
Environment=MODEL_DIR=/opt/DockerDate/cloudreve-embedding/models
Environment=AUTH_FILE=/opt/DockerDate/cloudreve-embedding/embedding_key
Environment=BIND_ADDRESS=172.27.0.1
Environment=BIND_PORT=18090
Environment=OMP_NUM_THREADS=4
Environment=OPENBLAS_NUM_THREADS=4
Environment=TOKENIZERS_PARALLELISM=false
Environment=PYTHONDONTWRITEBYTECODE=1
Environment=PYTHONUNBUFFERED=1
Environment=MAX_WINDOWS=32
ExecStart=/opt/cloudreve-embedding/venv/bin/python /opt/cloudreve-embedding/server.py
Restart=on-failure
RestartSec=15
CPUAffinity=0 1 2 3
MemoryMax=1G
TasksMax=64
LimitNOFILE=65535
NoNewPrivileges=true
ProtectSystem=strict
ProtectHome=true
PrivateTmp=true
ProtectKernelTunables=true
ProtectKernelModules=true
ProtectControlGroups=true
RestrictSUIDSGID=true
RestrictRealtime=true
LockPersonality=true
CapabilityBoundingSet=
DevicePolicy=closed
DeviceAllow=/dev/dri/renderD129 rw
DeviceAllow=/dev/dri/card1 rw
RestrictAddressFamilies=AF_INET AF_UNIX
IPAddressDeny=any
IPAddressAllow=172.27.0.0/16
IPAddressAllow=localhost

[Install]
WantedBy=multi-user.target
Meilisearch 一侧也要显式放行这个私网地址:MEILI_EXPERIMENTAL_ALLOWED_IP_NETWORKS=172.27.0.1/32,只开放这一个 NPU 接口的宿主地址。Cloudreve 侧的两项 AI 设置通过备份之后窄范围的 SQL 事务更新并重启读取,不修改其他设置、库结构或用户数据;原值保存在 private/before-ai.json(权限 600)。
另外,服务不依赖外盘,所以不会在硬盘缺失时阻塞开机;它 After/Wants Docker,绑定网桥暂未就绪时按 15 秒策略重试,不做无限等待。
部署要点
依赖与部署脚本
服务端只依赖 5 个 Python 包(/root/AI/cloudreve-embedding/requirements.txt):
numpy==1.26.4
tokenizers==0.19.1
psutil==7.2.2
ruamel.yaml==0.19.1
setuptools==75.8.0
部署入口是 /root/AI/cloudreve-embedding/install.sh:默认只预演,显式加 --apply 之后才会创建专用用户、落模型与虚拟环境、安装 systemd 单元并启动服务。
#!/usr/bin/env bash
# 默认预演;部署宿主机NPU服务,不自动改业务AI设置。
set -euo pipefail
base=$(dirname "$(readlink -f "$0")")
mode=${1:---dry-run}
[[ $mode == --apply || $mode == --dry-run ]] || exit 2
[[ $(uname -m) == aarch64 ]] || { echo '仅支持ARM64'; exit 1; }
[[ -c /dev/dri/renderD129 && -c /dev/dri/card1 ]] || { echo '请核对NPU设备'; exit 1; }
[[ $(findmnt -no SOURCE -T /opt) == $(findmnt -no SOURCE /) ]] || exit 1
[[ $(docker network inspect cloudreve-fts_fts --format '{{(index .IPAM.Config 0).Gateway}}') == 172.27.0.1 ]] || { echo '网桥地址变化,请先调整服务和嵌入配置'; exit 1; }
printf '准备系统盘模型、私密密钥及systemd专用用户服务:%s\n' "$mode"
[[ $mode == --apply ]] || exit 0
cd "$base"
sha256sum -c assets.sha256
getent passwd cloudreve-embedding >/dev/null || useradd --system --uid 10002 --user-group --home-dir /opt/cloudreve-embedding --shell /usr/sbin/nologin cloudreve-embedding
[[ $(id -u cloudreve-embedding) == 10002 ]] || exit 1
usermod -a -G render,video cloudreve-embedding
runtime=/opt/DockerDate/cloudreve-embedding
[[ $(realpath -m "$runtime") == "$runtime" ]] || exit 1
mkdir -p "$runtime/models" /opt/cloudreve-embedding
cp "$base"/assets/models/* "$runtime/models/"
chmod 755 "$runtime" "$runtime/models"
chmod 644 "$runtime"/models/*
[[ -x "$base/.venv/bin/python" ]] || python3 -m venv "$base/.venv"
if [[ ! -f "$runtime/embedding_key" ]]; then
 "$base/.venv/bin/python" -c 'import os,secrets;from pathlib import Path;p=Path("/opt/DockerDate/cloudreve-embedding/embedding_key");p.write_text(secrets.token_hex(32));os.chown(p,10002,10002);p.chmod(0o400)'
fi
cp "$base"/{server.py,engine.py} /opt/cloudreve-embedding/
[[ -x /opt/cloudreve-embedding/venv/bin/python ]] || python3 -m venv /opt/cloudreve-embedding/venv
ulimit -n 65535
taskset -c 0-3 /opt/cloudreve-embedding/venv/bin/python -m pip install --only-binary=:all: --index-url "${PIP_INDEX_URL:-https://pypi.tuna.tsinghua.edu.cn/simple}" -r "$base/requirements.txt" "$base"/assets/rknn_toolkit_lite2-*.whl
unit=/etc/systemd/system/cloudreve-embedding.service
if [[ -e "$unit" ]]; then cp -a "$unit" "$unit.bak.$(date +%Y%m%d-%H%M%S)"; fi
cp "$base/cloudreve-embedding.service" "$unit"
systemctl daemon-reload
systemd-analyze verify "$unit"
systemctl enable --now cloudreve-embedding
printf '%s\n' '服务已部署;Meilisearch须允许172.27.0.1/32,测试后单独执行integrate.py --apply,再重启Cloudreve加载设置。'
模型怎么跑在 NPU 上
实际的分工是拆开的:
CPU 负责分词、词/位置/类型嵌入查表和嵌入层 LayerNorm;
NPU 负责 4 层 Transformer 编码器与 CLS 输出;
CPU 再做 L2 归一化。
导出固定 batch=1、128/512 token,ONNX opset17;RKNN 不做 INT8 量化,内部为浮点 FP16。运行库是项目私有的 vendor/librknnrt.so,不复制到 /usr/lib、不执行 ldconfig、不安装也不启动 rknn_server。
这里不宣称"全部算子都完全在 NPU 执行",也不宣称达到 6 TOPS 峰值。可以确认的是:运行日志与三个 NPU 核心的非零负载证明是实机推理,不是 PC 模拟器;推理进程的内存映射已核对,确实加载了那个私有库。
长文本怎么处理
编码器单次最多 512 token,而 Cloudreve 的分块可能超过这个长度。直接截断然后悄悄丢掉后半段是绝对不能接受的——那等于索引了一半正文。
采用的方案是滑窗:128 token 用于短查询和短文,512 用于较长文本;长文本按 510 正文 token(另加 CLS/SEP)、16 token 重叠分窗,逐窗归一化后按窗口 token 数加权平均,再二次 L2 归一化,保持每段一个 512 维向量,以兼容 Meilisearch 的 REST 接口。所有窗口都参与,尾部不会被丢弃。
但要说清代价:聚合会稀释只出现在少数窗口里的主题,它不等同于多向量逐段搜索。验证时用了一个尾部航天主题做测试——完整长文与查询的相似度约 0.435,头部截断只有 0.173。真实复杂文档的召回质量仍需要用户用实际查询去评估。
另外,Cloudreve 固定使用 Chunk #... in a file named '...': ... 这样的模板来识别文档,其他自动类型输入会被当作查询并加上 BGE 中文检索指令;手工调接口时可以用 input_type=document/query 显式指定。如果将来 Cloudreve 升级改了模板,要先回归类型识别,不能照搬旧配置。
请求侧的护栏
单 NPU 并发,最多 8 个 HTTP 处理请求,每次最多 10 段文本,每段最多 16384 字符 / 32 窗口,请求体上限 1 MiB;
排队超过 15 秒返回 429,热区温度 ≥75°C 返回 503;
空文本或超限返回 400,不静默截断;
HTTP 请求与错误日志都不输出正文、文件名、密钥或向量。
常见坑
除了上面 Docker 那条,还有几个都是在这台机器上真实撞到的:
RKNN 枚举需要同时允许 NPU 的 card1 与 renderD129。只放行 renderD129 会导致初始化失败。白名单只加 NPU 相关设备与 video 组,不放开 GPU 和媒体设备。
端口冲突:8090 已被 1Panel 占用,正式部署改用检查为空的 18090。
Meilisearch 拒绝私网模型接口:1.54 默认会拦掉指向私网地址的模型请求(Rejected URI)。只增加
172.27.0.1/32一个允许值,并且仅重建 Meilisearch 本容器来载入,不动 Tika、网桥、密钥和索引目录。宿主 curl 打不通网桥:从宿主机直接 curl 网桥地址会超时,但从 Meilisearch 容器访问是成功的,这符合本机既有的网络限制。所以健康检查从 FTS 容器里发起,没有为了调试方便去改防火墙或开放监听。
空文本:512 版本对空字符串的向量余弦约 0.998493,低于常规样本但仍高于验证门槛。生产侧应当拒绝或跳过空文本,而不是照常入库。
隔离验证:先证明它真的能跑
在正式部署之前,先做了一个完全隔离的验证,结论是:128 与 512 token 固定长度 FP16 RKNN 编码器可以真实 NPU 推理,向量与 FP32 CPU 基准接近,无需升级驱动、内核或固件。这一阶段未部署常驻服务、未开放端口、未开启 Cloudreve AI、未写入 Meilisearch 业务向量。
所有样本都是脚本内自造的中文文本,不读取网盘正文,不上传业务内容。下面为热身后的单条中位数,同一模型、同一固定填充长度、CPU 只用实测的 A55 小核 CPU0–3、4 线程基准。端到端包括分词、查表/预处理、编码器和归一化,不含 HTTP、排队、Meilisearch 检索、文件提取或首次模型加载。
短文本实际只有 26–34 token,但被分别填充到 128/512,所以不能把这个倍数当作相对所有动态长度 CPU 实现的通用加速比。
检索样本共 12 段文档与 12 个查询,主题涵盖旅行、备份、做饭、登山、离职、网络安全、疫苗、预算、充电、维修、摄影、引用。查询"如何提高家里 WiFi 的安全性?"在 CPU 和 NPU 上都误把家庭预算文档排在第一,所以 11/12 不能说成真实业务 91.7% 的准确率——这不是正式的检索评测集,必须保留关键词与语义的混合检索。
重复性与长文本
连续 300 次 512-token 推理约 24.9 秒,中位 81.74 ms,P95 105.97 ms,重复向量最低余弦 0.99999988;该对比进程 RSS 约 468 MiB。
464 token 近上限中文样本最低余弦 0.999967。
1995 token 文本分 5 窗,逐窗 CPU/NPU 最低余弦 0.999819。
2414 token 样本分 5 窗,尾部标识保留。
临时任务采样 11 个线程全部落在 CPU0–3;各任务温度最高 49.923°C,现有的 80°C CPU 守护保持运行。
上线之后又验了什么
128/512 的 NPU 数值、完整 Torch 与 ONNX 拆分一致性、6 项局部测试、300 次重复 / 混合中英文 / 近上限和尾部验证全部通过。
REST 认证拒绝、空值 / 超长 / 批量超限处理、512 维归一化、长文尾部主题参与全部通过。
用 Meilisearch 临时 4 文档测试自动嵌入:纯语义旅行查询首位命中 trip,owner_id=1 的结果不包含 owner 2,无权 owner 999 返回 0 条,临时索引随后清理。
业务索引 554 个分块全部嵌入为 554 个向量,任务 46 成功,待处理 0;混合查询返回 5 条结果,其中 5 条为语义命中,owner 999999 为 0。这个业务请求只输出计数和 ID,不打印正文——它不是网页登录搜索的回归测试。
NPU 服务重启后健康检查、混合搜索和全线程 CPU0–3 通过;Meilisearch 重启后向量持久化、服务继续可用。
正式服务进程启动后约 212 MiB RSS,索引完成后约 313 MiB RSS;两个编码器常驻。内存上限 1 GiB 是约束,不代表实际用量。模型 101 MiB、正式虚拟环境约 130 MiB,索引 du 约 16 MiB。
注意事项与局限
这些边界比结论本身更重要,直接照抄部署前请先读完。
没有整机重启验证,没有真实功耗测量,也没有长时间高并发测试。
没有做网页登录后的语义搜索结果评估。上面那 5 条语义命中来自带计数和 ID 的接口请求。
测试过程中 Cloudreve 曾短暂重启导致 HTTP 000,那是启动窗口,随后恢复 200;历史失败日志保留,不隐去。
没有长期烤机或用功耗计测量,不能宣称已经测出节电比例。
宿主 curl 到网桥超时属于本机既有网络限制,验证都是从 FTS 网络发起的。
模型接口或网桥地址变化时,要先评估正在使用的其他应用;不要删 Docker 网桥。需要同步修改的至少包括 systemd 的 BIND_ADDRESS/端口、IPAddressAllow、Meilisearch 的最小 /32 允许地址,以及 Cloudreve/Meilisearch 的 embedder URL。绝对不要把允许范围改成 0.0.0.0/0。
日常管理与回退
systemctl status cloudreve-embedding --no-pager
journalctl -u cloudreve-embedding -n 30 --no-pager
systemctl restart cloudreve-embedding

# 健康检查从 FTS 容器访问;宿主访问网桥可能被既有 1Panel 网络规则拦截
# 不要为了方便检查而开放局域网或公网监听
docker exec cloudreve-fts-meilisearch sh -c 'wget -T 5 -qO- http://172.27.0.1:18090/health'

cd /root/AI/cloudreve-embedding
.venv/bin/python runtime_check.py
.venv/bin/python check_index.py
如果要恢复成纯关键词搜索,顺序很重要——先恢复应用设置,不要先停接口,否则 AI 请求会直接失败:
cd /root/AI/cloudreve-embedding
.venv/bin/python integrate.py --rollback           # 默认预演
.venv/bin/python integrate.py --rollback --apply   # 明确应用原两项设置与原嵌入配置
systemctl restart cloudreve
# 确认设置恢复、任务成功后,再禁用 NPU 服务
systemctl disable --now cloudreve-embedding
回退时去掉 cr-text 嵌入器会删除向量,但不删除文本索引和网盘文件;再次启用会重新生成向量。首次普通部署用 install.sh 默认预演,--apply 安装源码、模型和服务;接入需要单独执行 integrate.py --apply 并重启 Cloudreve,不会自动重建文档。Meilisearch 侧只 PATCH 嵌入器,没有重建或删除业务文本。
这套东西也做了还原归档:部署源码是独立 Git 仓库 /root/AI/cloudreve-embedding,归档在 /root/AI/backup/cloudreve-embedding-npu,包含源码、模型 / RKNN / Lite2 运行库与 wheel、systemd 单元、测试、运维文档、Meili Compose 参考;排除私密密钥、实际 Cloudreve AI 配置、数据库 / 业务索引 / 正文、虚拟环境和失败实验的镜像层。依赖是 ARM64 Ubuntu、Python 3.12 venv、兼容 RKNPU 驱动、Docker FTS 网络、render/video 组,以及空闲的 18090 端口。
cd /root/AI/backup/cloudreve-embedding-npu
sha256sum -c MANIFEST.sha256
./restore.sh          # 默认 dry-run
./restore.sh --apply
重装时先恢复 Cloudreve 与 FTS / 固定 USB 挂载,再恢复本服务;恢复脚本不自动覆盖 FTS Compose,也不自动打开 Cloudreve AI——需要手工合并 Meilisearch 的最小允许地址、重建 Meilisearch、测试接口并执行
integrate.py --apply,最后重启 Cloudreve。新密钥会自动生成,需要重新接入;旧密钥应另作加密私密备份。归档务必拷出设备,eMMC 重装会清空。
验证过程另外归档在 /root/AI/backup/embedding-npu-verify,它没有常驻服务;其中旧文档属于隔离阶段的历史,不会反向覆盖生产设置。
参考:Cloudreve 的 AI 语义搜索文档、Meilisearch 自托管配置参考、airockchip 的 rknn-toolkit2,以及 BAAI/bge-small-zh-v1.5 模型页。
附:完整脚本
上面步骤里用到的完整脚本不再整段贴在正文,已作为附件上传到对象存储,点击文件名即可下载:
对象存储策略会自动把文件名改写成 UUID(例如
95D96A8A-FB38-4CCB-AB42-F6E906E70760.py),这是存储策略的行为,不影响文件内容;下载后按正文里的路径改名放好即可。